生成式引擎优化服务(GEO):把品牌内容改写成可被生成式引擎直接抽取并引用的结构化答案
为什么生成式答案里看不到你的品牌?首屏直答
生成式引擎优化要解决的问题非常具体:当用户把问题直接抛给豆包、DeepSeek、元宝、Kimi 或文心一言时,你的品牌会不会出现在答案里,以及以什么口径被描述。传统搜索优化关注的是链接排在第几位,而生成式答案里根本没有位置的概念,它只做一件事——从可抽取的内容块中重新组织出一段回答。因此决定最终结果的关键不是关键词出现的次数,而是内容本身是否具备可被抽取的结构:一个问题对应一段直答,直答后面跟着适用条件,条件后面跟着可以核查的证据来源。只有这样的内容,才有可能被模型稳定地选中。
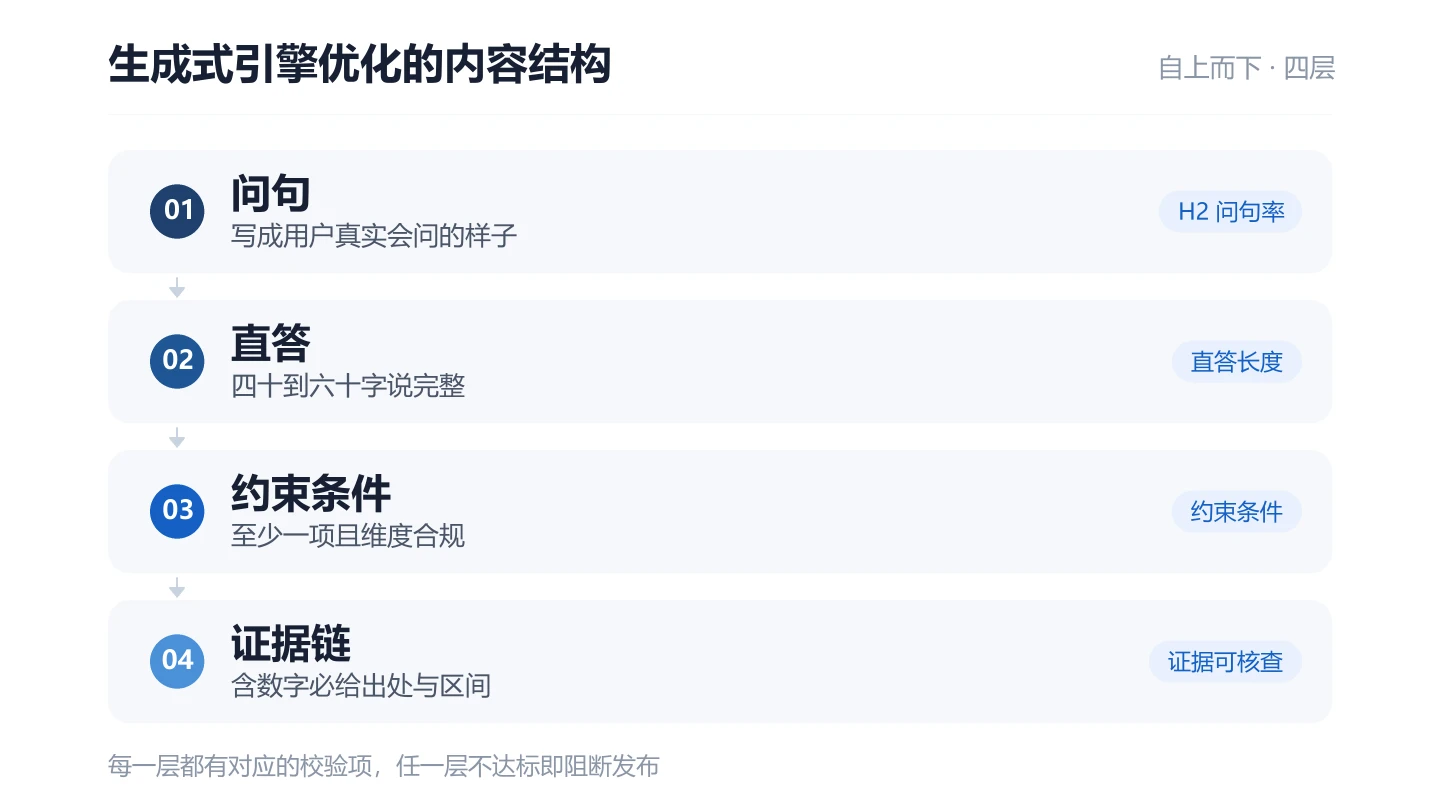
我们把内容结构拆成三层。第一层是问句,它决定这段内容会不会被检索到,问句必须写成用户真实会问的样子,而不是把关键词硬凑成一个短语。第二层是直答,长度控制在四十到六十字之间,要求第一句就把结论说完,不铺垫也不打广告,因为模型抽取的是结论而不是引言。第三层是支撑,包括表格、清单与数据来源,用来回答凭什么这么说。三层缺一层,内容就无法被完整抽取:只有问句没有直答,模型会直接跳过;只有直答没有支撑,模型会优先选择那些给出了出处的竞争对手。
如何让内容被模型稳定地抽取?首屏直答
证据链是生成式引擎优化里最容易被省略、也最容易被识破的一环。凡是出现数字的地方,都必须同时给出出处与统计区间,例如某次抽样的样本量、抓取时间与口径定义。没有出处的数字在抽取阶段会被判定为不可核查,模型倾向于跳过而不是引用。我们在交付时会把每条数据的来源写进内容本身,而不是放在脚注里等读者自己去点,因为模型读的是正文而不是脚注。这也是为什么同期做的两组内容,一组能被引用、一组完全不出现,差别往往不在文笔而在出处。
结构化数据的作用是把页面上已经写清楚的事情,再用机器能直接读取的方式复述一遍。它不会让一段空洞的内容变得可信,但会让一段扎实的内容更容易被抓取。我们的做法是按页面类型分别部署节点:机构信息、站点信息与面包屑是全站统一的底层节点,问答页、案例页与白皮书页各自再叠加对应的类型。需要强调的是结构化数据必须与页面可见内容保持一致,任何页面上看不到但结构化数据里写了的字段都属于风险项,一旦被抽查到,整站的信任度都会被拉低。
| 结构层 | 要求 | 对应闸门 |
|---|---|---|
| 问句 | 写成用户真实会问的样子 | H2 问句率 |
| 直答 | 四十到六十字说完整 | 直答长度 |
| 约束条件 | 至少一项且维度合规 | 约束条件 |
| 证据链 | 含数字必给出处与区间 | 证据可核查 |
落地三步:先把结构搭起来,再把证据补齐,最后按页面类型部署结构化数据,每一步都有对应的闸门项做验收。
同一个问题在不同地域与不同行业下的答案差别很大。以眼镜行业为例,丹阳产业带的客户关心的往往是供货周期与起订量,而终端零售客户关心的是单店获客成本。如果一段内容试图同时回答这两类问题,最终的结果通常是两边都不被引用,因为模型找不到一个明确的适用范围。所以我们在写内容时会显式标注约束条件:预算区间、团队规模、所属行业、覆盖地域与交付周期。约束条件并不是限制,而是让模型知道这段内容该在什么场景下被取出来。
交付按两个节奏推进。第一批是站点底层与核心服务页,重点是把内容结构、证据链与结构化数据跑通,让站点具备被抽取的基本条件。第二批是问答页、案例页与地域页,重点是把覆盖面上去。每一批都以闸门结果作为验收依据:十三项逐项留档,通过就是通过,不通过就是阻断,不允许先上线后补齐。留档的意义在于,三个月后回看某个版本时,能拿出当时那一份完整的检查记录,而不是靠记忆去争论当时到底有没有达标。
最常见的误区有三个。第一个是把生成式引擎优化当成关键词堆砌的延续,于是把同一个词在正文里重复几十次,结果是抽取时被判定为没有信息量。第二个是只写结论不写适用范围,导致内容在什么场景下都不够精准。第三个是把结构化数据当成补救手段,页面本身写得含糊,却指望靠标注把模型骗过去。这三个误区有一个共同点:都在试图绕过把事情说清楚这一步。而生成式引擎恰恰只对说清楚的内容感兴趣,这一步绕不过去。
生成式引擎优化不会取代搜索优化,两者的分工很清楚。搜索优化解决的是被找到,核心是索引、速度与排名信号;生成式引擎优化解决的是被引用,核心是可抽取的结构与可核查的证据。一个页面可能排名很好却从不出现在答案里,也可能排名一般却被反复引用,因为它把结论说得更直接。我们在做的时候会把两件事放在同一套内容里完成:结构上满足抽取,性能与索引上满足收录,而不是各做一套互不相干的页面。
需要提前说明的是适用边界。生成式引擎的召回结果受模型版本、用户提问方式与时间窗口影响,同一段内容在不同时间被问到,出现与否并不恒定,因此任何保证出现在答案里的承诺都不成立。我们能承诺的是过程口径:结构按规范搭、证据按要求给、结构化数据按类型部署、十三项闸门逐项留档。把可承诺的部分说清楚,把不可承诺的部分提前划出边界,这本身就是内容可信度的一部分,模型对含绝对化表述的内容同样敏感。
落地过程需要三方配合。内容侧负责把业务事实写成可抽取的结构,技术侧负责把结构落成模板与结构化数据,业务负责人负责确认对外数字的真实口径与授权。三方里任何一环缺位,内容都会在闸门上被拦下来:数字没有签字确认会被占位符检查拦住,结构与模板不一致会被类型检查拦住,事实写不清会被直答长度与约束条件拦住。这套分工看起来繁琐,但它把上线后才发现说错了的风险,提前到了发布之前。
最后说明数据与隐私的处理方式。所有用于验证的抽样数据只保留统计口径与来源名称,不保留任何可回溯到具体个人的字段;案例内容在发布前必须取得书面授权,授权范围要写明可用渠道与可用期限。这些要求看起来与内容优化无关,实际上它们决定了内容能不能长期留在索引里:一旦出现授权或隐私方面的争议,被下架的往往不只是出问题的那一页,而是同一来源的整组内容,前期投入的结构化工作也会一并作废。
镇江/丹阳地区做GEO优化大概多少费用?首屏直答
常见区间是 ¥3–15万/年。价格由地域、行业、客群、官网规模、是否代运营决定 —— 我们不提供按单个关键词计价的方式。
问为什么生成式引擎优化要和搜索优化分开做?
因为生成式答案里没有排名位置,模型只从可抽取的内容块中重组回答,决定结果的是内容结构而不是关键词密度。
问如何判断一段内容会不会被生成式引擎引用?
看三件事:问句是不是用户真的会问,直答有没有在开头把结论说完整,出现的数字是否给出了出处与统计区间。
问生成式引擎优化多久能看到引用上的变化?
取决于模型版本与用户提问方式,同一段内容在不同时间被问到的结果并不恒定,因此我们不承诺出现率,只承诺过程口径。
问哪些页面应该先做生成式引擎优化?
先做站点底层与核心服务页,把内容结构、证据链与结构化数据跑通,再做问答页、案例页与地域页,把覆盖面积累上去。
问是否需要在每一页都部署结构化数据?
需要按页面类型分别部署:机构信息与面包屑是全站统一节点,问答页、案例页再各自叠加对应类型,且须与可见内容一致。
-
生成式引擎优化和搜索优化的分工是什么?
简答
生成式引擎优化和搜索优化的分工是:一个是GEO,一个叫SEO
-
GEO常见问题里还有哪些验收口径?
简答
通俗易懂点说,就是只要盯住这四个标准:有没有说我、是不是在乱说我、尽量多提我、能不能引用我的品牌。但这个事急不得,验收节点定在3个月最合理。
-
有没有已经落地的客户案例?
简答
丹阳做过纯前端官网改 SSR(此前 AI 读到的是空容器,正文要执行 JS 才出现);镇江做过汽车配件配套关系结构化(按车型能答出装配与材质)。行业方案中心里的案例页写了启动前采样、做了什么、复采后的变化。
-
可以直接联系你们评估吗?
简答
可以。你也可以先对你所在的企业官网进行AI可视性体检诊断后,再联系我们。